Jev 到底是什么?一个不聊天、只做判断的模型
设想你开了一家店,门口装了闸机。你请来一位文笔极好的编剧,专门负责一件事:判断这个人能不能进店。
每次有人走近,他都认真地写下一段话:
这位顾客穿着整洁,神情平静,手里提的东西大概率不是危险物品。综合判断,我认为可以进店。
你读完,点点头,然后自己伸手按下了开门键。
问题不在于他判断得对不对,而在于——你原本只想要一个「开」或「不开」,他却交给你一段还要你再读一遍、再理解一次的叙述。
在软件里,大语言模型经常就站在这个位置。它很会写、很会解释,但程序真正需要的往往只是一个判断:这笔工单要不要升级?这条评论要不要拦?这个订单要不要转人工?让模型写一段自然语言,程序还得反过来解析、校验,再猜这句话到底是什么意思。
Jev 就是冲着这个问题来的。
TypeSafe AI 把 Jev 称为第一款公开的 System One Model:它不面向人聊天,而面向软件内部的决策。程序给它一段状态和一个结构化的问题,它返回程序可以直接接着处理的类型化结果、概率分布和置信度。
这也是 Jev 最容易被误解的地方:它不是「一个更小的 LLM」,也不是给普通 LLM 的回答套一层 JSON。它改变的是模型在软件系统里的位置。
本文依据 TypeSafe AI 的公开介绍和目前可见的接口资料,回答四个问题:Jev 的输入输出是什么?它和传统分类模型有什么区别?它和 LLM 的结构化输出、ReAct 又差在哪里?以及什么场景适合用它。
说明:Jev 的架构、权重和完整训练细节尚未公开。下面把厂商的公开定位、接口行为和工程推断分开写,不把宣传页上的性能数字当作独立评测结果。
先从一条客服消息说起
客服系统收到这样一条消息:
我的银行卡被扣款两次了,订单号是 A-104。程序接下来可能要做三件事:
- 判断这是不是疑似重复扣款;
- 在「自动回复」「支付团队」「人工客服」里选一个路由;
- 评估要不要立刻升级处理。
传统做法是写规则:命中「扣款两次」「重复扣款」这些关键词就升级。规则便宜、稳定,但用户换个说法——「一笔订单扣了两遍」「为什么金额翻倍了」——就得不断补条件。
换 LLM 来做,可以让它只返回一段 JSON:
{
  "is_duplicate_charge": true,
  "route": "payment_team",
  "risk": 0.82
}
看起来已经是结构化结果,但调用方还是得担心几件事:JSON 一定合法吗?字段会缺吗?0.82 到底指什么?要是模型顺手多写了一句解释,这行解析还崩不崩?
Jev 的做法,是把问题本身也变成接口的一部分:程序明确给出状态和候选答案,模型直接在这些候选上返回概率分布。它交出去的不是给人读的段落,而是工作流下一步能直接消费的数据。
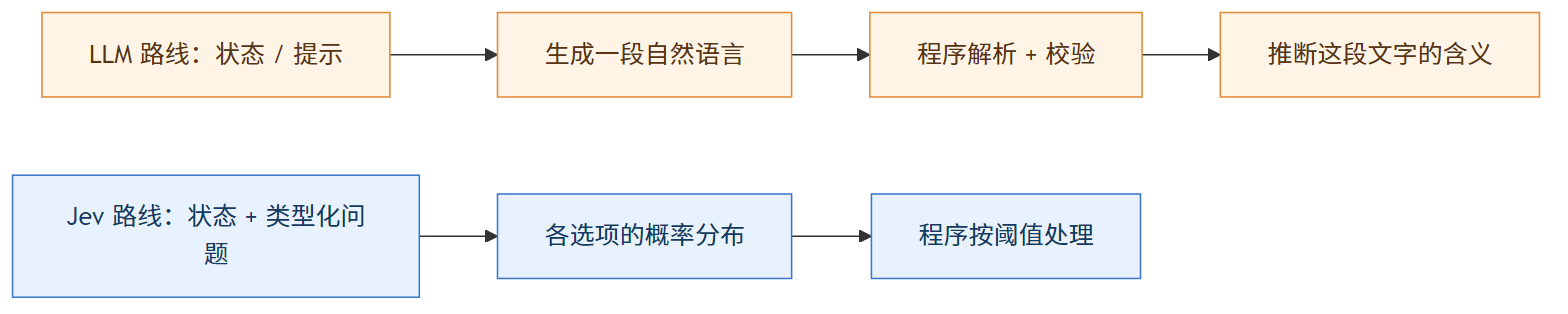
图 1:两条路线真正的区别,不在模型大小,而在「交还给程序的是什么」。示意图,非实测。
真正变化的不是「模型能不能回答」,而是程序能不能明确知道:这个回答是什么类型、有多不确定、下一步该拿它怎么办。
Jev 的输入和输出:状态 + 类型化问题
根据公开资料,Jev 接收两类信息:一个状态,以及一个或多个 typed question(带类型的问题)。
状态可以是一段文本、一个 JSON 对象或一个字符串数组。比如:
{
  "message": "我的银行卡被扣款两次了",
  "order_id": "A-104"
}
问题不是随手写的一句自然语言,而是带类型和候选标准的结构化对象。公开资料里出现的基本类型有三类:
- 布尔判断:是或否;
- 选择题:从一组无序选项里选一个;
- 评分题:在有序等级里判断状态处在哪一档。
示意地说,程序可以这样问:
{
  "is_duplicate_charge": {
    "type": "noul",
    "instructions": "这是否疑似重复扣款?",
    "criteria": {
      "true": "消息描述同一笔交易被扣款多次",
      "false": "消息没有描述重复扣款"
    }
  },
  "route": {
    "type": "choice",
    "instructions": "应该把工单路由到哪里?",
    "criteria": {
      "payment_team": "支付问题处理团队",
      "general_support": "普通客服团队",
      "fraud_review": "风险审核团队"
    }
  }
}
模型返回的核心结果,是每个问题对应的概率分布。系统可以据此选最可能的选项,也可以自己定阈值:
支付团队:0.78
普通客服:0.14
风险审核:0.08
如果最高概率只有 0.42,程序就不一定要硬着头皮自动执行,而可以把它转给人工。这种设计的价值在于:不确定性成了接口的一部分,而不是藏在一段看起来很确定的文字里。
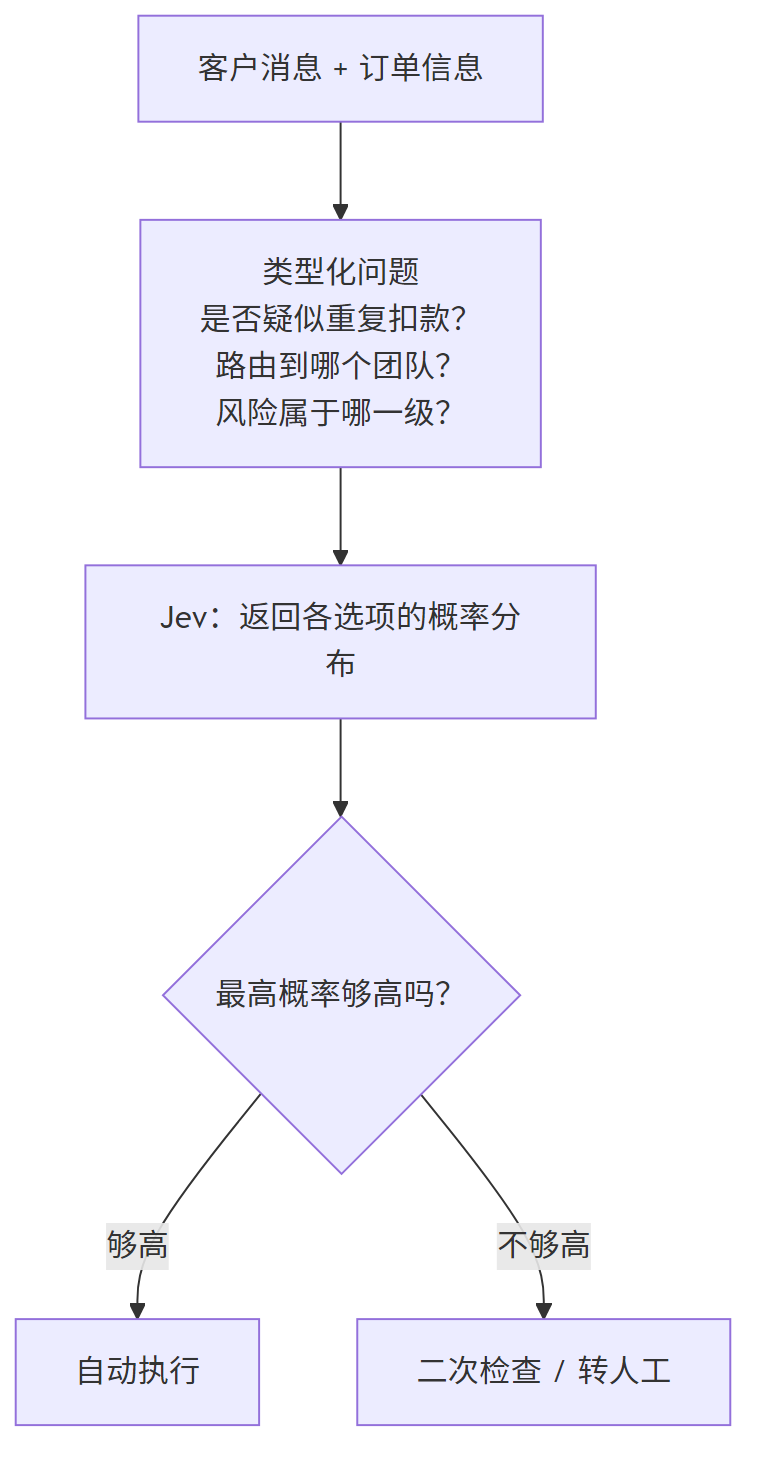
图 2:Jev 的输出不是终点,而是工作流里的一个决策信号。示意图,非实测;具体接口以 TypeSafe AI 当前文档为准。
这里有两个必须说清的边界。
第一,所有问题是并行回答的,问题之间不能有依赖。 如果「路由到哪」要看「是否重复扣款」的结果,就得拆成两次请求:先问第一层,再带着答案问第二层。
第二,模型给出的「置信度」不自动等于真实世界里的正确概率。 公开资料显示,接口返回的 confidence 是由概率分布按固定公式算出的集中程度——分布越集中,数值越高。它衡量的是模型对自己的判断有多笃定,而不是它在你的业务数据里会不会真的判对。一个模型声称自己有 90% 的把握,不代表它恰好对 90% 次;是否校准,需要在目标任务和实际数据分布上单独验证。
它和传统分类模型有什么区别?
Jev 和分类模型确实有相似之处:都能把输入映射到离散类别,也都能输出类别概率。所以不能简单说「Jev 完全不是分类模型」。更准确的区别,在于使用方式和泛化层次。
| 对比项 | 传统分类模型 | Jev 的公开定位 |
|---|---|---|
| 类别从哪里来 | 通常在训练前固定 | 可以在问题里提供候选标准 |
| 要不要为每个任务单独训练 | 多数情况需要任务数据训练或微调 | 目标是根据上下文做零样本判断 |
| 输出 | 类别、分数或概率 | 类型化决策、概率分布和置信度 |
| 放在哪里 | 模型服务或分析管线 | 软件工作流里的决策节点 |
| 主要工程问题 | 数据、特征、训练和部署 | 问题定义、阈值、升级和后续动作 |
举个例子:一个传统垃圾邮件分类器,通常要先定好「垃圾邮件 / 正常邮件」两个标签,再用对应数据训练。如果想再加一个「钓鱼邮件」或「营销邮件」类别,往往得重新准备数据、重新训练或调整模型。
Jev 的目标接口则允许程序在请求里描述问题和候选标准。这里的「无需为每个类别重新训练」是它的产品方向,既不意味着它不需要评估数据,也不意味着随便写几条候选描述就能得到可靠结果。
所以更合适的理解是:传统分类器通常把分类任务固化在模型或训练数据里;Jev 试图把分类标准前移到调用那一刻。
它和 LLM 的结构化输出有什么区别?
这是最容易混淆的一组比较。
LLM 的结构化输出,是让一个生成模型按指定格式吐内容。比如要求它只返回 JSON、只用枚举值,或者按 JSON Schema 组织字段。它仍然是在生成 token,只是生成过程被打上了格式约束。
Jev 的公开定位从另一端出发:它不是先生成一段回答再解析,而是直接把「判断」当作输出对象。
两者的差异可以简化成两条链路:
LLM + JSON Schema:
自然语言生成模型 → 受约束的文本/JSON → 程序解析

Jev:
状态 + typed question → 概率分布/类型化决策 → 程序执行
这并不是说 LLM 的结构化输出没用。只要任务需要长文本、代码、解释、复杂对象或开放式提取,LLM 依然更合适。
但如果任务只剩「是否通过」「选哪个路由」「风险属于哪一级」,直接换成决策模型,可以把接口收得更窄,也更容易把失败策略写进系统:
置信度 ≥ 0.90 → 自动执行
0.60 ≤ 置信度 < 0.90 → 二次检查
置信度 < 0.60 → 转人工这里真正可靠的部分,不是模型独自完成了决策,而是模型负责判断,代码负责阈值、权限和动作。如果把这些规则继续交给模型用自然语言去描述,Jev 的工程优势也就被削弱回去了。
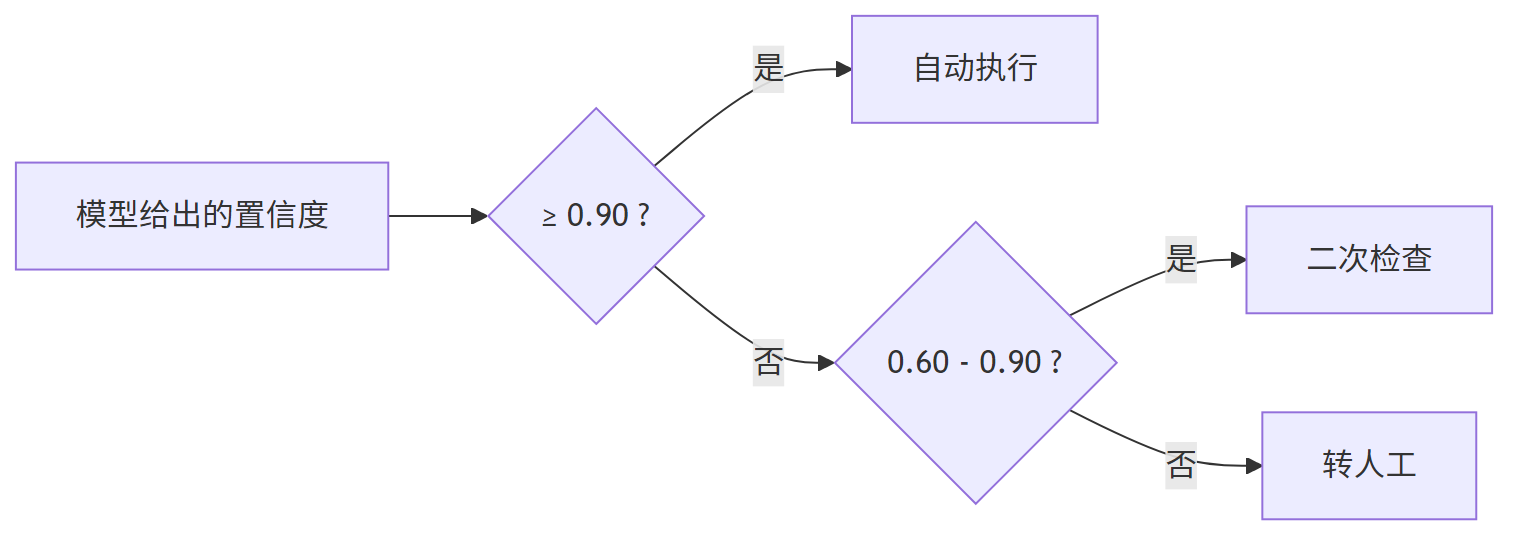
图 3:把「不确定」写进代码,而不是交给模型即兴发挥。数值为示意阈值,并非 Jev 的默认配置。
它和 ReAct、Agent 又有什么区别?
Jev 不是 Agent Loop,也不是 ReAct 的替代品。
ReAct 或其他 Agent 模式主要解决的是:模型怎么在观察、思考、调用工具、拿到结果之间循环,一步步完成一个开放任务。比如:
读取网页 → 判断下一步 → 调用搜索工具 → 分析结果 → 再调用工具Jev 解决的是其中某一个「判断节点」:
当前状态 → 选一个动作 / 类别 / 评分 → 交给工作流继续执行两者是组合关系,而不是二选一。Agent 负责走完开放任务的循环,Jev 负责循环里某个需要稳定判断的节点。比如:Agent 负责理解用户想退款,Jev 负责判断这笔退款是否满足自动处理条件,业务代码负责真正去调用退款接口。这样分工,比「让一个聊天模型决定是否直接退款」更容易审计。
Jev 更像一个决策原语
把 Jev 放进系统里,职责可以拆成四层:
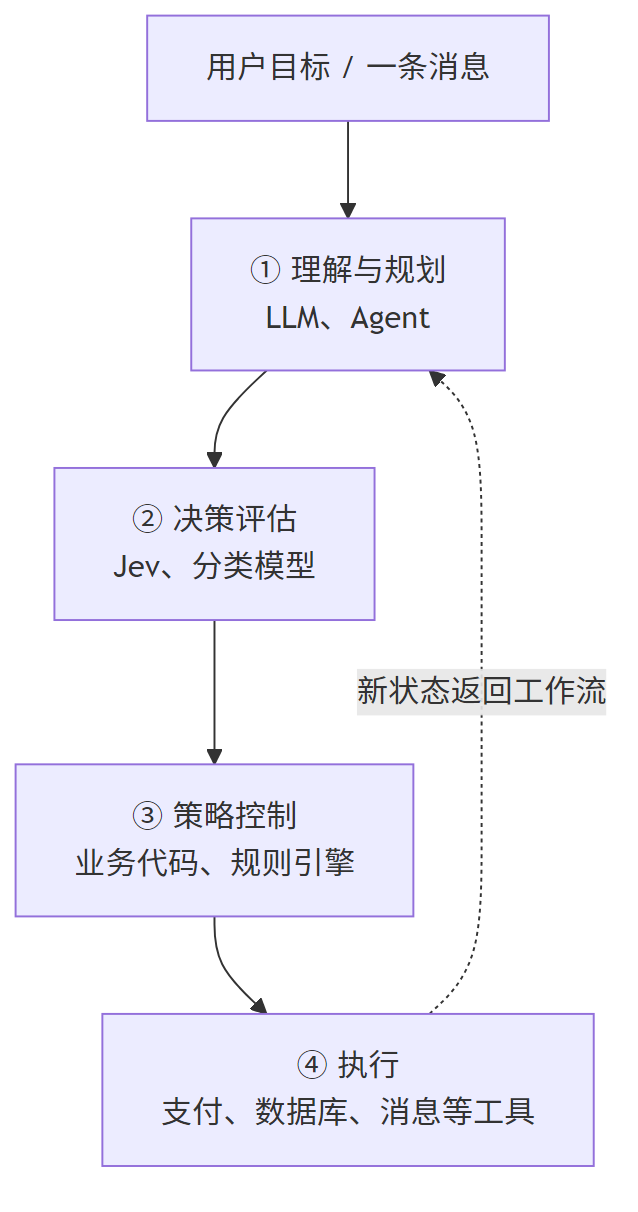
图 4:把系统职责拆成四层后,Jev 的位置就很清楚了——它只占「决策评估」这一层。示意图,非实测。
这张图也划出了 Jev 的边界:它不是把整个应用变成「无需代码的智能体」,而是把某些原本由规则或通用 LLM 承担的判断节点,单独抽出来。
在工程上,这种边界有三个好处。
第一,输出更容易验证。调用方知道自己拿到的是布尔值、枚举值还是评分,而不是一段需要猜含义的文字。
第二,不确定性更容易接进流程。程序可以设自动执行阈值,也可以要求高风险类别必须人工确认。
第三,模型和工作流可以分开演进。业务规则、权限和工具调用仍由代码掌控,模型只负责被明确描述的那个判断。
但这三个好处都需要额外的系统设计。没有验证集时,置信度只是一个数;没有阈值和人工回退时,类型化输出也不等于安全;没有清晰的问题定义时,把输入结构化并不会自动让判断变可靠。
哪些场景适合,哪些不适合?
Jev 更适合这类任务:
- 工单分类和队列路由;
- 内容审核的初筛;
- 风险等级判断;
- 判断是否需要人工复核;
- 从有限候选动作里选下一步;
- 对稳定标准做批量判断。
它们的共同点是:候选结果相对明确,程序也知道该怎么处理每个结果。
它不适合直接替代这些任务:
- 写长篇文章、邮件或代码;
- 需要多轮探索的复杂规划;
- 候选项无法预先定义的开放式问题;
- 没有目标数据验证,却要求把置信度当成真实概率;
- 需要模型自主执行高风险动作,却没有权限控制和人工回退的系统。
尤其要小心「模型给出了概率,所以它比 LLM 更可靠」这类推论。概率输出解决的是接口和不确定性表达问题,并不会自动解决数据偏差、概念歧义、分布变化和错误标准。
最后:Jev 真正的区别是什么?
如果只用一句话概括:
LLM 主要生成供人理解的内容;Jev 试图生成供软件执行的决策。
它和传统分类器有交集,但把候选标准和问题描述挪到了调用侧;它和 LLM 的结构化输出都能返回机器可读结果,但 Jev 从设计上就把类型、概率和置信度当作核心接口;它也能参与 Agent 工作流,却不负责完整的规划和工具执行。
所以,Jev 值不值得用,不该只看它是不是「新模型」,而要看你的系统里有没有这样一个节点:
输入状态比较复杂,规则难以覆盖;
输出空间又比较明确,代码知道如何处理;
系统还需要知道模型有多确定,并在不确定时回退。
如果答案是肯定的,Jev 可以被理解为一个值得评估的机器原生决策原语。如果任务本质上是生成、解释和开放式规划,那么传统 LLM 或 Agent 仍然是更直接的选择。
参考资料
- TypeSafe AI 官方主页:https://typesafe.ai/。页面介绍了 System One Models、Jev、RLCD、typed decisions 和面向软件自动化的定位。
- Jev 公开资料整理:https://en.wikipedia.org/wiki/Jev_(AI_model)。其中包含目前可见的输入问题类型、概率分布和输出说明;实际接入时应以 TypeSafe AI 的当前 API 文档为准。
云服务器推荐
如果你需要部署博客、Docker 服务或个人项目,可以参考:
本文包含推广链接。通过链接购买不会增加你的费用,但我可能获得少量佣金。
评论