Session 已经持久化了,为什么还需要 Durable Execution?
假设你让 Agent 往 CHANGELOG.md 追加一条记录。模型发出工具调用,工具改好了文件,进程却在保存工具结果之前退出了。
重启以后,聊天历史还在,模型提出的工具调用也在,只是没有对应的结果。现在应该再执行一次吗?
再执行,文件里可能多出一条重复记录。不执行,又不能直接告诉模型“已经成功”,因为会话记录没有这个证据。
Session 已经持久化,不代表这次执行已经具备可靠的恢复办法。 Durable Execution 要补上的,正是从“记录还在”到“知道怎样继续”这一段。
先看没有中断时,Agent 怎样完成任务
我们把任务稍微展开一点,先看它在没有中断时怎样完成:
给
CHANGELOG.md追加一行“修复登录超时”,然后运行pytest -q,最后汇报结果。
下面用这个假设任务贯穿全文。为了容易看懂,先假设只有一个工具调用在执行,没有并行、重试和上下文压缩。append_note 是教学例子里的工具名,不是 rpi 的内置工具;rpi 可以通过 bash 完成相同的文件追加动作。
这里有四个角色:
- 模型根据输入生成回复,也可以提出工具调用。它不会因为生成了一段调用参数,就亲自修改磁盘文件。
- 执行器是调用模型、分发工具、接收结果的程序。通常所说的 Agent Loop,主要由它驱动。
- 工具执行实际操作,例如修改文件、运行测试,再把结果返回给执行器。
- Session 保存会话历史,让执行器以后能重新取出这些消息。
一次正常执行可以分成几步。执行器先保存用户任务,把任务和已有历史发给模型。假设模型先要求追加记录,执行器保存这条工具调用,再调用 append_note。
工具修改文件后返回“追加成功”。执行器把这个结果保存为一条工具消息,然后再次请求模型。这一次,模型能同时看到原任务、自己先前提出的调用,以及调用结果。它才有依据继续提出“运行测试”。
测试结果返回后,执行器再把它交给模型。模型生成最终汇报,执行器保存回复并结束本次运行。
简化成教学伪代码,就是:
messages = session.load_messages()
messages.append(user_task)
session.save(user_task)

while True:
    reply = model.generate(messages)
    session.save(reply)
    messages.append(reply)

    if not reply.tool_calls:
        break

    for call in reply.tool_calls:
        result = tools.execute(call)
        message = tool_result(call.id, result)
        session.save(message)
        messages.append(message)
这段程序已经保存了用户消息、模型回复、工具调用和工具结果。本文所说的“仅消息持久化”,指的就是这种能力范围,不是一个只存最后答案的简陋聊天记录器。
先记住一个动作:工具返回以后,执行器还要再调用一次模型。模型不是一直悬在那里等工具回来,再从原来的思考位置继续;执行器需要把更新后的消息放进下一次请求。
Session 是持续保留的会话,里面可以有多次用户提问。run 则是执行器为处理一次输入而启动的一轮驱动过程,可能包含多次模型请求和工具调用。会话还在,不代表其中某次运行还在进行。
进程退出以后,究竟留下了什么
我们先看一个容易恢复的位置,暂时把“结果丢失”的难题放一放。假设追加已经成功,工具结果也已保存。进程在下一次模型请求发出之前退出了。
此时会话里有三条业务消息。下面用便于阅读的格式展示,不对应任何供应商的 API 协议:
消息 1:用户任务
  追加“修复登录超时”到 CHANGELOG.md,
  然后运行 pytest -q,最后汇报结果。

消息 2:模型提出工具调用
  call_id: call-9
  tool: append_note
  args:
    path: CHANGELOG.md
    line: 修复登录超时

消息 3:工具结果
  call_id: call-9
  result: 已追加一行
磁盘上的 CHANGELOG.md 也已经多了一行。它和上面的会话消息是两份不同的数据:一份是操作产生的外部效果,一份是执行器保存的结果记录。
消失的是进程内存:while 循环执行到哪里、当前的 messages 变量、等待下一次模型请求的异步任务,都随进程退出而消失。新进程不会自动回到旧循环的下一行。
如果新程序启动后只做这件事:
messages = session.load_messages()
show_history(messages)
wait_for_user_input()
那么消息确实恢复了,任务却停在那里。没有程序去发起下一次模型请求,测试当然也不会自己开始。
这不是说所有 Session 产品都只能等用户输入,而是这段实现没有包含恢复调度。把数据库换掉,或者让历史保存得更完整,都不会自动补上缺少的那次调用。
现在也可以回答一个很直接的问题:既然最后一条是工具结果,启动时一律继续请求模型,不就行了吗?
对这个简单例子,这可以是一条恢复规则。但应用一旦采用了它,就已经开始实现执行恢复。还要处理工具要求结束运行、用户明确取消、任务暂停等情况,不能把所有以工具结果结尾的历史都当作待办任务。
消息当然可以承载这些状态。关键不是必须额外建一张 runs 表,而是程序要有明确依据,区分“可以查看的过去”和“还欠一次执行的工作”。
让新进程接手,需要把记录变成动作
接下来,我们给刚才的程序补上一组运行记录,看看新进程能据此做出什么判断。字段仍是教学示意,暂时不用对照 rpi 的真实存储格式:
run_started
  run_id: run-17
  task: 消息 1

工具调用消息:消息 2,call-9

tool_started
  run_id: run-17
  call_id: call-9
  effective_args: 消息 2 中实际执行的参数
  replay_policy: never

工具结果消息:消息 3,call-9,已追加一行

# 进程在这里退出,没有 run_finished(run-17)
run_started 表示系统开始处理这次任务。正常结束时,执行器会写对应的 run_finished。两者配对后,新进程就能找出没有正常收尾的运行,不用让模型猜“用户是不是还希望我继续”。
call_id 则把调用和结果对应起来。恢复时需要确认“call-9 有结果”,而不只是“历史里出现过某条成功消息”。同一个会话可能修改过很多次文件,它们不能混用结果。
tool_started 保存执行时的参数和重跑策略。这里的 never 表示不能因为结果缺失就自动重跑旧调用。追加不是可以随便重复的动作:同样的调用执行两次,会追加两行。这也叫非幂等操作。
在结果已经保存的这个窗口,恢复步骤并不复杂:
- 宿主启动,打开已有 Session,调用恢复程序。
- 恢复程序找到没有结束记录的
run-17。 - 它按调用 ID 核对消息,发现
call-9已有结果,不再执行这次追加。 - 它确认当前消息允许继续请求模型,把这次运行登记为待续接工作。
- 宿主驱动待续接工作,执行器加载消息,发起新的模型请求。
这些步骤都是应用里的程序行为。“恢复器”就是负责检查记录、处理遗留状态并安排后续工作的那部分代码,不是另一个负责猜测进度的模型。
只画这个成功续接分支,时序如下。重点看进程退出后的第一条箭头:新进程先读记录,随后才决定发起什么请求。
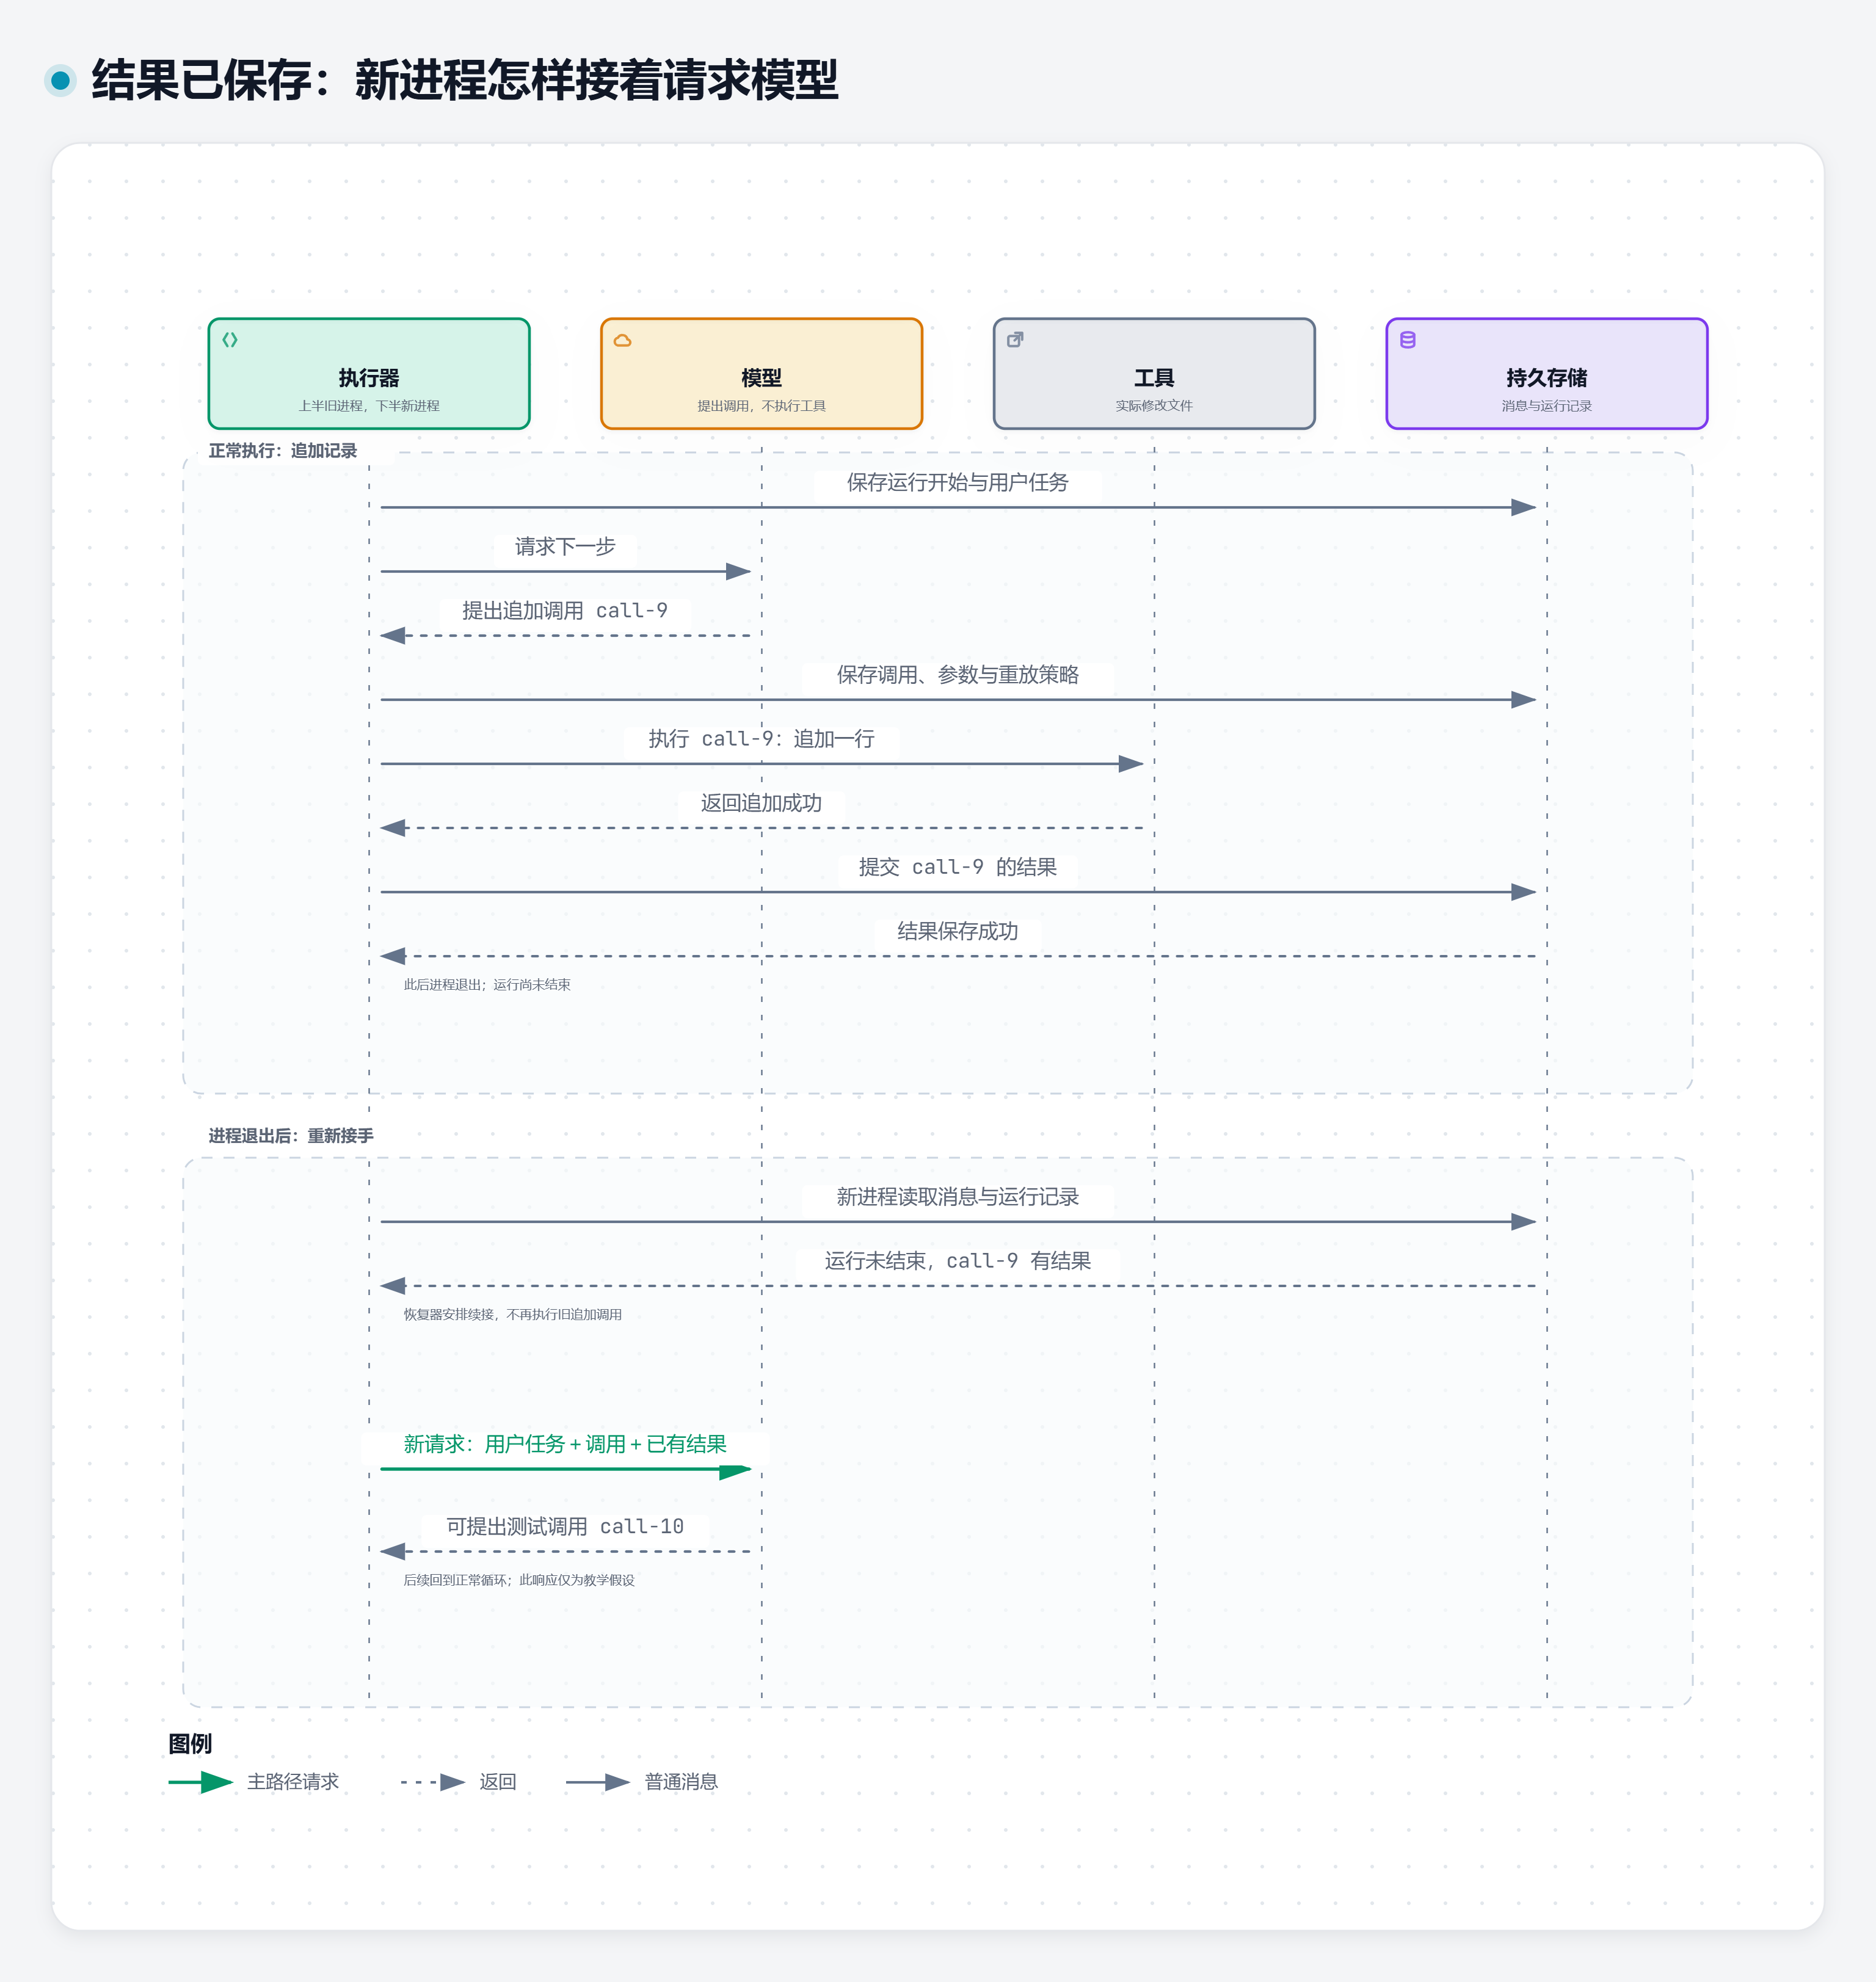
图:教学概念时序,不是 rpi 的实测轨迹。上半段与下半段的执行器分别属于旧进程和新进程;记录写入均假设成功。图只画“结果已保存”的分支,尚未保存的情况在下一节展开。点击图片可放大,也可打开原图或交互查看。
下一次模型请求里,具体放什么
恢复程序已经决定继续,接下来要把什么发给模型?我们把这次请求的输入展开来看。请求要保留原来的消息关系,不能只有一句孤立的“继续”,也不能把原始用户任务当成新任务从头发一遍:
system:
  当前系统指令

user:
  追加“修复登录超时”到 CHANGELOG.md,
  然后运行 pytest -q,最后汇报结果。

assistant / tool_call:
  id: call-9
  name: append_note
  args:
    path: CHANGELOG.md
    line: 修复登录超时

tool / tool_result:
  call_id: call-9
  content: 已追加一行

# 请求还携带当前可用工具的定义,例如运行命令的工具。
这里列的是本例完整的业务消息顺序,省略了真实协议里的时间戳、用量等字段。实际应用还可能有更早的历史、压缩摘要和恢复提示。
这次请求已经包含“追加成功”,因此执行器无须通过再次调用 append_note 来获得结果。这就是复用已有结果:读出先前保存的工具消息,把它放进模型输入。
假设模型接下来返回:
调用 call-10:运行 pytest -q执行器便回到正常循环:保存 call-10,执行测试,保存测试结果,再请求最终汇报。这个分支正常完成后,记录会继续增长为:
assistant:提出 call-10,运行 pytest -q
tool:call-10 的实际测试结果
assistant:依据实际结果生成的最终汇报
run_finished:run-17,completed
这里没有预先填入“测试通过”。执行器要等工具真正返回,模型才能据此汇报。后续响应也只是教学假设,不保证模型必然选择测试;它仍可能需要澄清,或提出不同的调用。
把以上动作放进代码,控制流大致如下:
# 教学伪代码:单运行、顺序工具;保存成功才进入后续步骤。
# 省略并发接管、分支、取消、预算和存储错误处理。
def recover_on_startup(session):
    for run in session.find_unfinished_runs():
        messages = session.load_messages_for(run)

        for call in find_calls_without_results(messages):
            # 这里才处理结果缺失:重跑,或者补“结果未知”。
            resolve_missing_result(session, run, call)

        messages = session.load_messages_for(run)
        if (not run.cancelled
                and all_calls_have_results(messages)
                and last_message_is_tool_result(messages)
                and not tool_requests_stop(messages)):
            scheduler.enqueue_continuation(run.id)


def drive_continuation(run_id):
    messages = session.load_messages_for(run_id)
    reply = model.generate(messages, tools=current_tools)
    # 保存新回复,执行它提出的新调用,再进入正常循环。
agent_loop.accept_reply(run_id, reply)在刚才的快照里,find_calls_without_results 返回空集合。恢复程序不会执行任何旧工具,只安排下一次模型请求。伪代码只覆盖本文的工具结果续接分支,不是任意 Agent 状态的通用恢复算法。
Durable Execution,可以译作持久化执行,补上的就是这套能力:保存恢复所需的进度与意图,在新的进程里读取它们,并按规则推进未完成工作。保存只是前半段;后半段必须真的调用调度器、模型或工具,才构成执行恢复。
如果连工具结果都没有留下,应该怎么接
现在我们回到开头那个更难的窗口,把中断位置往前挪一步:CHANGELOG.md 已经修改,call-9 的结果却没来得及保存。
此时消息只有用户任务和工具调用。恢复程序能识别出 call-9 缺结果,却不能仅凭这个缺口判断文件有没有改过。
把相邻的几个中断位置放在一起,就能看出区别:
| 中断位置 | 已保存的依据 | 新进程能做出的判断 |
|---|---|---|
tool_started 已保存,尚未调用工具 | 调用、参数、策略,没有结果 | 不能只靠这些记录确认外部效果 |
| 文件已改,结果尚未保存 | 调用、参数、策略,没有结果 | 与上一行可能看到相同记录,效果仍未知 |
| 结果已保存,尚未再次请求模型 | 调用与对应结果,运行尚未结束 | 可以复用结果,安排下一次模型请求 |
前两行在真实世界里不同,在恢复程序眼里却可能相同。新进程没有看到旧进程的最后一条机器指令,只有已经提交的记录。
为什么保存 tool_started 还不够
我们把“保存执行记录”和“修改文件”排一下顺序,看看为什么多写一条记录仍然不够:
先写 tool_started → 再追加文件如果进程刚写完记录就退出,文件还没改。如果追加完文件才退出,文件已经改了。两种情况都可能只留下 tool_started。
反过来先改文件、再写记录也不行。进程可能在两步之间退出,留下一个没有记录的文件修改。
问题在于:会话记录的提交与 CHANGELOG.md 的修改,不在同一笔原子事务里。所谓原子,是指几件事要么一起发生,要么都不发生。这里两边各自写入,中间就可能中断。仅在 Session 数据库内部使用事务,也不能自动把外部文件修改包进去。
所以,缺少结果只说明结果没有成功记录,不能证明工具没有生效。 持久化执行必须正面处理这个未知,不能把它当作普通失败再试一次。
不可安全重跑:先把未知告诉下一轮
对于文件追加,恢复程序可以给 call-9 补一条明确的结果:
tool / tool_result:
  call_id: call-9
  is_error: true
  content:
    上次执行在结果保存前中断。
    外部效果未知,可能已追加,也可能没有。
恢复程序没有自动重跑该调用。这不是伪造“追加失败”。is_error 表示这次调用没有正常留下可确认的结果,文字内容仍明确区分了失败与未知。
补齐结果有两个作用。它让下一次请求里的工具调用有对应答复,也让模型看见这一步的不确定性,而不是把缺口悄悄当作成功。
后续可以由应用要求模型先读取 CHANGELOG.md,检查目标记录,再决定要不要补做。如果文件可能被其他人修改,或者相同文字可能原本就存在,简单搜到一行也未必足够证明原调用成功。核对规则要由任务本身决定,无法确认时可以转给用户。
拒绝自动重跑旧调用,也不能阻止模型在下一轮重新提出相同写操作。应用仍需约束后续新调用;不能只加一条未知消息,就宣称整个系统不会重复修改。
可以安全重跑:重新执行并保存新结果
如果缺结果的是读取文件,且工具声明允许安全重跑,恢复器可以重新执行读取,把返回内容保存为原调用的结果,然后继续请求模型。
这里确实执行了工具,与“使用已保存结果”不同。而且重新读取的是当前文件,未必等于中断前读到的内容。安全的含义是允许重复这个动作,不是保证返回过去的同一个值。
对发消息、创建订单等外部操作,还可能需要下游提供幂等键,让重复提交被识别为同一次业务操作;或者通过查询接口核对原请求的结果。执行器不能凭自己的一条日志,替另一个系统保证恰好执行一次。
对照 rpi:这些步骤实际落在哪里
前面的记录和伪代码是为了说明机制。带着“结果已保存”和“结果未知”这两条路径,我们再对照 rpi 这个 Rust Agent 项目的实际实现。核查版本为 0.15.0、提交 fd47e29,下面会分别说明教学字段与 rpi 真实记录的对应关系。
运行过程中,先保存哪些恢复依据
rpi 使用 operation_started、operation_finished 表示一次操作的开始与收尾。正常提示路径会把首条用户输入与运行开始记录一起提交,恢复时就有依据查找未结束的操作。
模型提出工具调用后,执行器会尝试提前提交携带调用的 assistant 消息,不等整轮任务结束。准备执行工具时,再保存 tool_started,包含所属运行、调用 ID、实际参数、预留的结果条目 ID,以及当时的重放策略。
工具返回时,执行器会尝试把结果提交到预留条目。这样,若追加结果已经保存、进程却在后续模型请求之前退出,新进程能够读到完整的调用与结果,而不用再追加一次文件。
这些提交边界可以在 settle.rs 的 settle_assistant、start_tool、settle_tool_result 中核对。但“尝试保存”不能读成“无论存储怎样失败,状态都不会丢”。部分写入失败路径只记录告警,并不会一律阻止工具执行。本文的恢复判断以相应记录成功提交为前提,未验证磁盘断电和损坏时的保证。
重启时,谁发起下一次模型请求
宿主在允许恢复已有会话的模式下构造 AgentHarness。create 会查找未结束的操作,修复上次中断留下的状态,再判断当前消息是否适合续接。
对本例“结果已保存”的位置,关键依据是:之前有未结束的运行,当前分支已经到工具结果,而且这个结果没有要求终止运行。符合条件时,Harness 登记一个 PendingResume,也就是待续接任务。
登记本身还没有请求模型。宿主调用 resume_pending 后,Harness 才实际进入续接路径。rpi 的交互启动代码与其他运行模式中都有这个调用入口,不需要用户重新输入原任务。
续接也有保护条件:次数预算用尽,或消息处在不允许继续的位置时,不会直接启动。已经正常结束或明确取消的运行,没有那条未结束操作,也不该因为打开历史而重新执行。
rpi 还有一个容易被“恢复原任务”掩盖的实现细节:它会先把旧 operation 以 Aborted / interrupted 收尾,再为续接建立新的 operation。新记录通过 resumedFrom、resumeAttempt 保留关联及续接次数。
从用户角度看,任务接着做了;从运行记录看,这是新的执行过程接手旧上下文。原进程的 Rust 调用栈、旧 HTTP 连接和内存变量都没有被复活。
结果缺失时,按什么规则处理
rpi 的 resolve_tool_call 负责处理缺少结果的调用。对普通本地工具调用,它要求两项条件同时成立,才会自动重跑:调用当时保存的策略是 Safe,当前注册的工具仍声明为 Safe。
历史策略说明当时是否允许重跑,当前声明说明现在是否仍允许;缺少其中一项,就不能仅凭工具名字猜测。
CLI 默认工具中,read、docs 显式声明为 Safe。bash、write、edit 默认是 Never。因此,即使某一次 bash 看起来只是读文件,它也不会自动获得安全重跑资格;执行器按注册策略处理,不靠分析 shell 字符串来证明安全。
用 bash 追加记录后中断,若结果缺失,恢复器不会再次执行那条旧命令。它会补上说明外部效果未知的工具结果,让后续模型请求有明确的事实边界。即便调用消息已经保存、进程还没来得及写 tool_started 就退出,也不能据此自动断言“工具一定没有执行”。
Safe 声明由工具注册者承担。它是一项安全承诺,不是 Harness 自动证明了工具实现没有副作用。
本次复核还运行了 rpi 的无新提示续接测试。它使用模拟 Provider,并通过中止任务制造中断;没有用真实模型跑完本文的三步任务,也不是断电实验。本地另有教学脚本用子进程退出验证上表三个窗口,两者的实现和验证范围不同。
除了当前工具,还有哪些工作不能只留在内存里
文件追加只是一个最容易看见的中断点。同一原则也适用于排队输入和等待中的重试。
例如,Agent 正在运行,用户又发来一句“测试结束后也检查格式”。应用如果已经确认接收,却只把指令放在内存队列里,进程退出后这项工作就消失了。聊天界面上能看见一句话,也不等于执行器记住了它尚未处理。
rpi 在把输入发布到内存队列之前,先保存入队记录。恢复时据此重建仍待处理的输入,而不是把会话里每句用户消息重新执行一遍。
重试也类似。请求失败后,如果决定稍后重试,内存里的计时器会随进程消失。rpi 在进入等待前保存 retry_pending 意图,让恢复代码能识别“这次工作还在等待重试”,而不是只剩一条失败消息。
这些记录首先是给执行器安排工作用的,不必全部变成模型聊天内容。保存对话和保存待办可以共用 Session 存储,但由不同代码读取,并产生不同动作。
判断自己的实现,缺的是哪一步
如果只需要打开历史、由用户决定何时继续,消息持久化可以满足这个产品目标。如果系统承诺重启后接手已接受的任务,我们可以沿着一次工具调用,在下面三个位置检查自己的实现:
- 结果已保存、下一次模型请求未发出时退出:谁识别未结束运行,谁实际发起新请求?
- 外部操作可能完成、结果尚未保存时退出:依据什么允许重跑,不能重跑时怎样暴露未知?
- 运行已正常结束或用户已取消后重启:依据什么阻止它被再次当成待办?
这三个问题不要求买一个名字叫 Durable 的产品,也不要求把所有状态搬出 Session。它们要求应用写出明确的记录与恢复规则。
回到追加记录这件事:如果结果已经保存,就把它交给下一次模型请求;如果结果没有保存,就先处理这一步的不确定性。能在新进程里完成这些动作,才从“历史还在”走到了“工作有人接手”。
云服务器推荐
如果你需要部署博客、Docker 服务或个人项目,可以参考:
本文包含推广链接。通过链接购买不会增加你的费用,但我可能获得少量佣金。
评论