Pi、rpi、Pi-Bolt 重测:rpi 在启动、内存与读取上全面领先
在这组 Pi、rpi、Pi-Bolt 固定版本重测中,rpi 的 RPC 就绪耗时为 6.76 ms,就绪 RSS 为 15.75 MiB,完成 100 次文件读取的完整循环耗时为 123.11 ms。三项都低于另外两者。
相比 Pi,rpi 的启动耗时少约 96.6%、就绪内存少约 85.8%、读取循环耗时少约 59.3%。相比 Pi-Bolt,三项分别少约 84.8%、84.9% 和 25.6%。这些结果来自同一批测量:各加载一个功能对齐的扩展、开启默认会话持久化,均取七轮中位数。
这是 Agent 自身开销的比较,使用本地模拟模型。真实模型推理、编码任务质量和交互终端渲染不在本轮测试范围内。
同一批次,启动、内存、读取三项领先
三种程序运行在同一台 Ryzen 9 7950X、Ubuntu 24.04 / WSL2 机器上,Agent 固定四个逻辑 CPU。各自加载一个功能相同的轻量 echo 扩展,开启默认会话持久化;每组预热两次、正式测量七次,交错运行。
| 程序 | RPC 就绪 ms | 就绪 RSS MiB | 100 次 read 完整循环 ms |
|---|---|---|---|
| rpi 优化后快照 | 6.76 | 15.75 | 123.11 |
| Pi-Bolt | 44.40 | 104.00 | 165.55 |
| Pi / Node | 199.31 | 110.83 | 302.27 |
三列各自取中位数。RPC 就绪从创建进程计到收到 get_state 回复;RSS 是静置采样后的进程常驻内存;读取循环计到完整 agent_settled,包含工具执行、上下文处理、会话记录与结算。它们分别回答不同的问题,不能相加成一个“性能分”。
启动更快:约 6.76 ms 完成 RPC 就绪
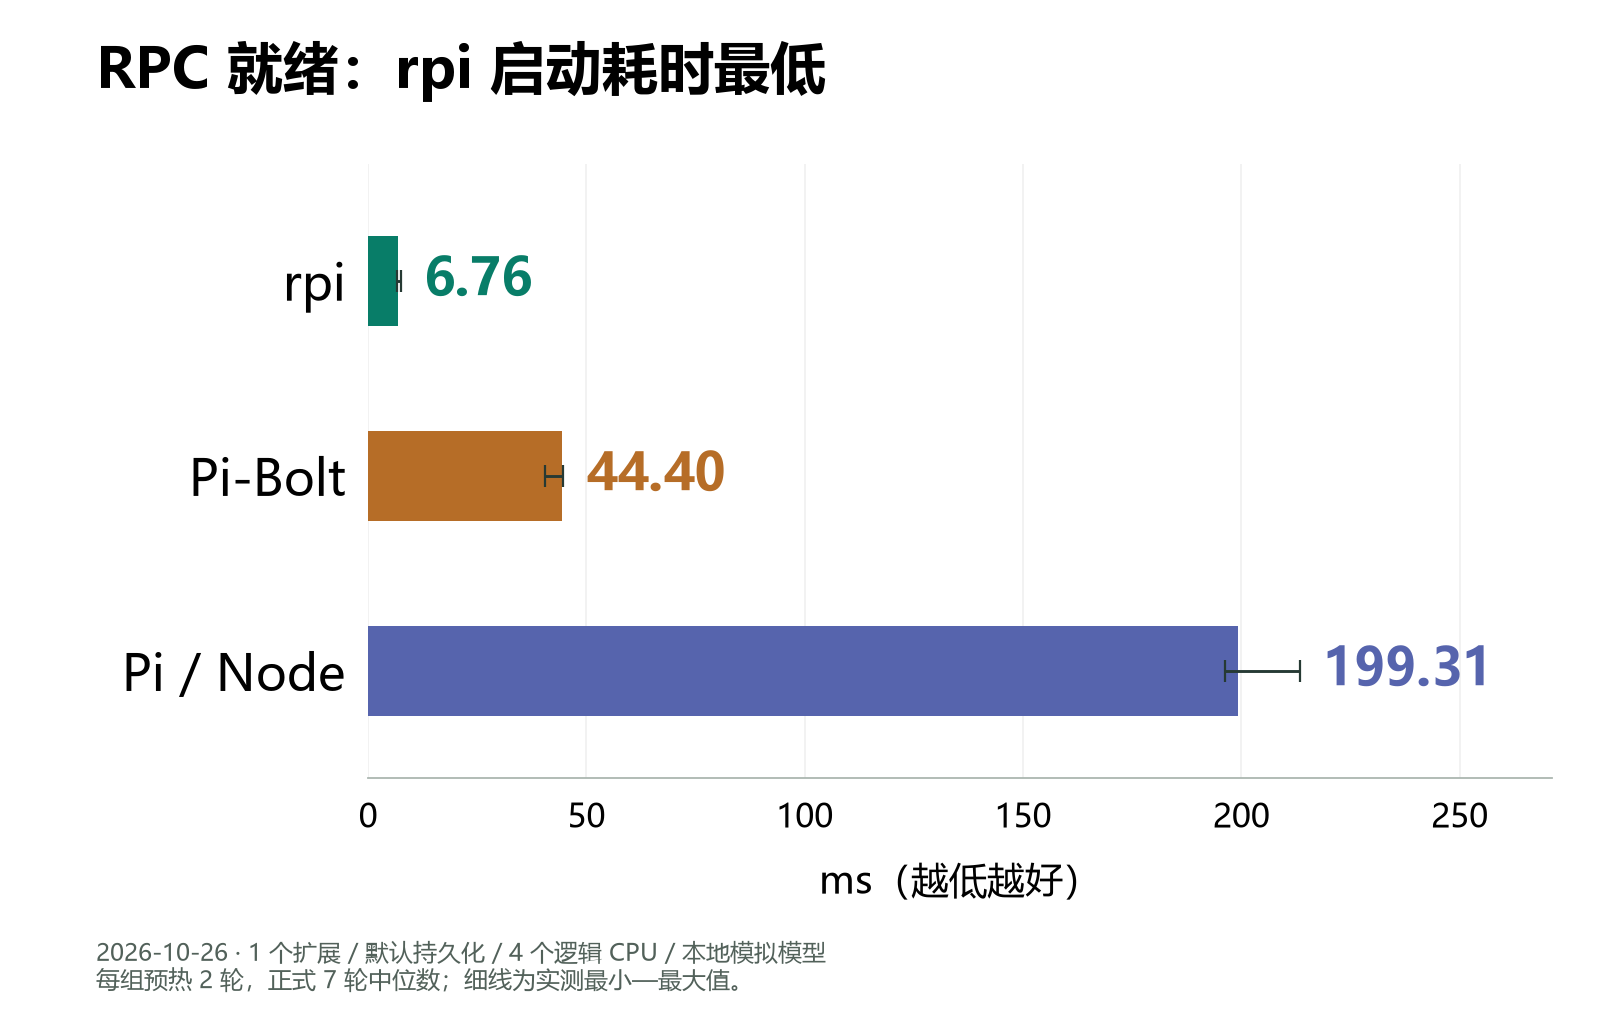
一个扩展、默认持久化;七轮中位数,细线为实测最小—最大值。越低越好。
rpi 的这项优势体现在新进程启动阶段。需要频繁拉起 Agent 时,6.76 ms 的就绪开销是一个更小的起点。这里测的是 RPC 服务能够回复状态,没有测交互终端首屏,也没有载入长历史会话。
内存更省:就绪时 RSS 为 15.75 MiB
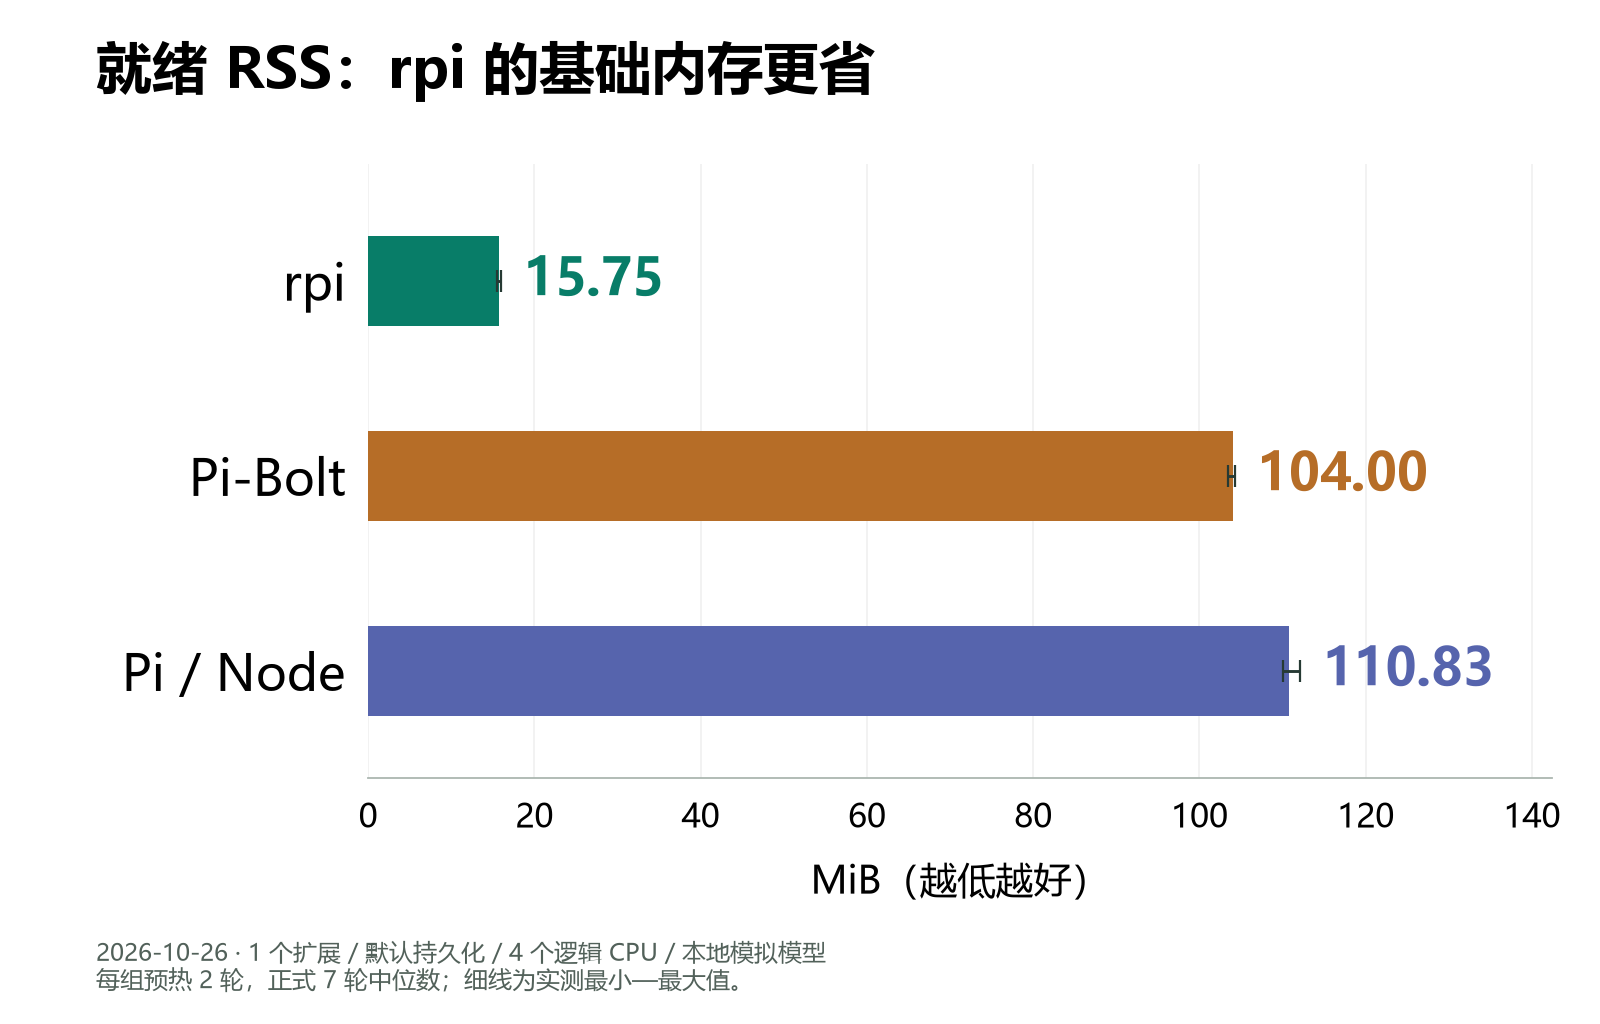
RSS 包含驻留的代码、栈、堆与运行时页面,不等于堆分配量或长期峰值。采样口径相同,展示七轮中位数与范围。
Pi-Bolt 为 104.00 MiB,Pi 为 110.83 MiB。对关注单进程基础内存预算的场景,rpi 的优势很直观。本轮没有测多 Agent 并发容量,也不据此推算一台机器能承载多少个实例。
读取更强:保留持久化,100 次循环仍领先
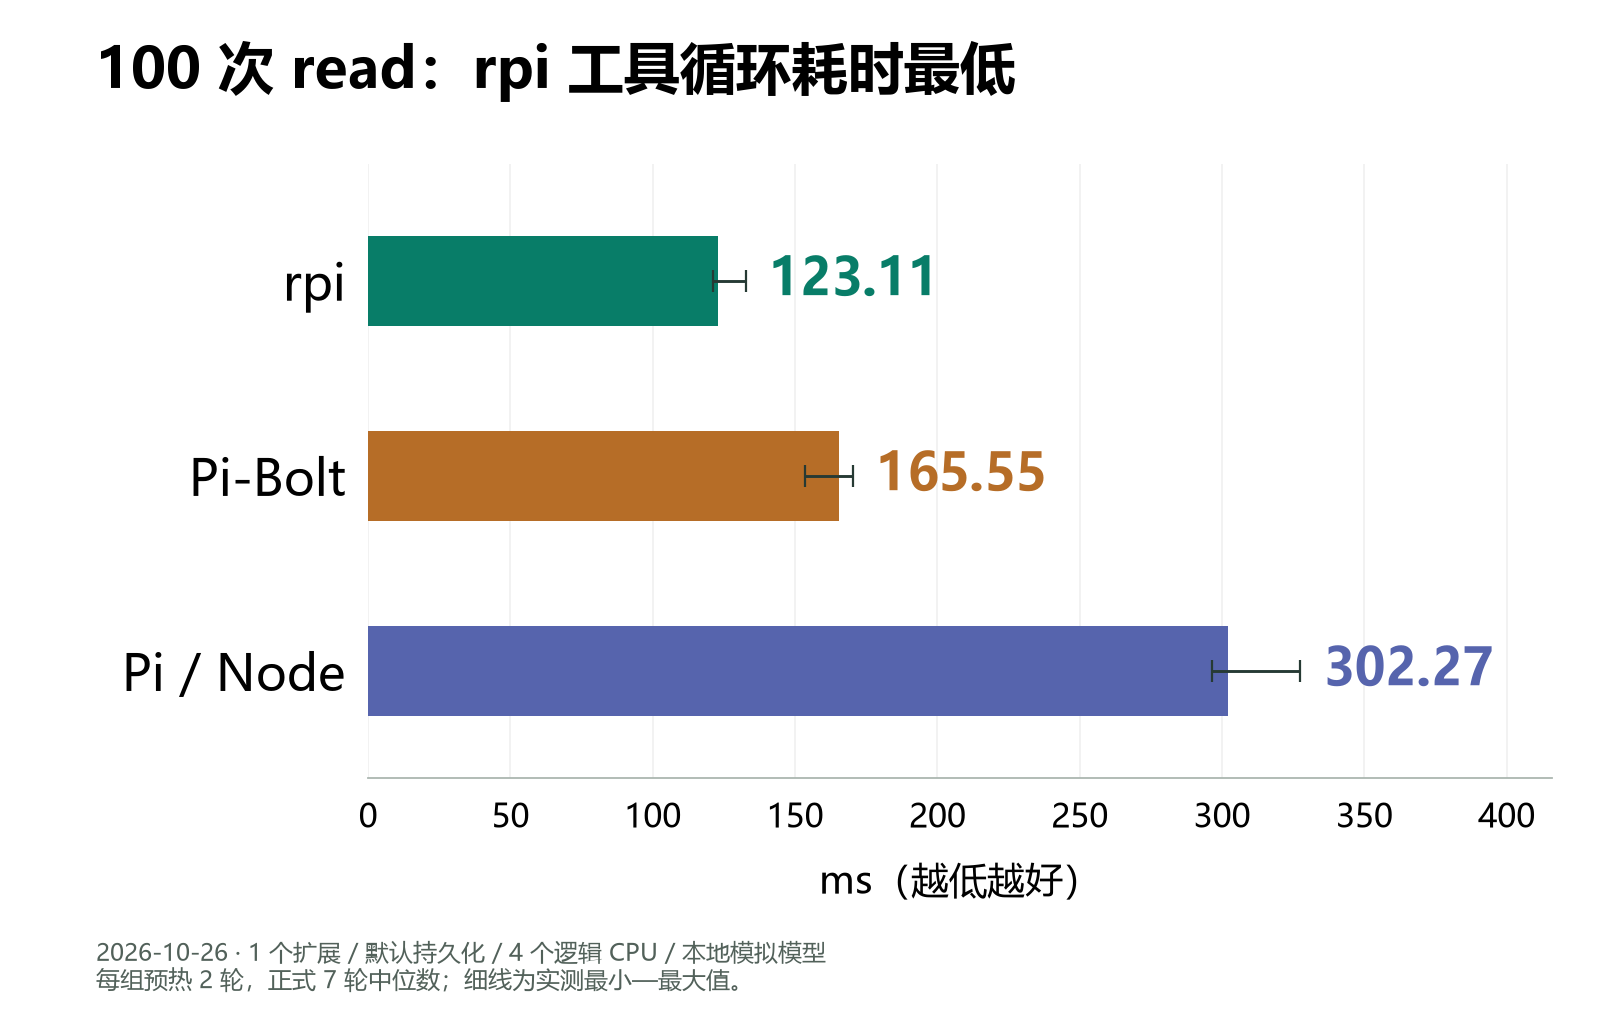
三者都实际读取同一个 208 字节文件 100 次,由本地模拟模型逐次发起调用,校验每次结果,共 101 次模型请求。时间计到完整结算,未提前截在输出结束。
rpi 用时 123.11 ms,Pi-Bolt 为 165.55 ms,Pi 为 302.27 ms。相比 Pi-Bolt,rpi 少用约四分之一的时间;相比 Pi,少用约六成。
云服务器推荐
如果你需要部署博客、Docker 服务或个人项目,可以参考:
本文包含推广链接。通过链接购买不会增加你的费用,但我可能获得少量佣金。
评论